
Вот я и закончил свое исследование "распределение игроков по языкам в Deadlock".
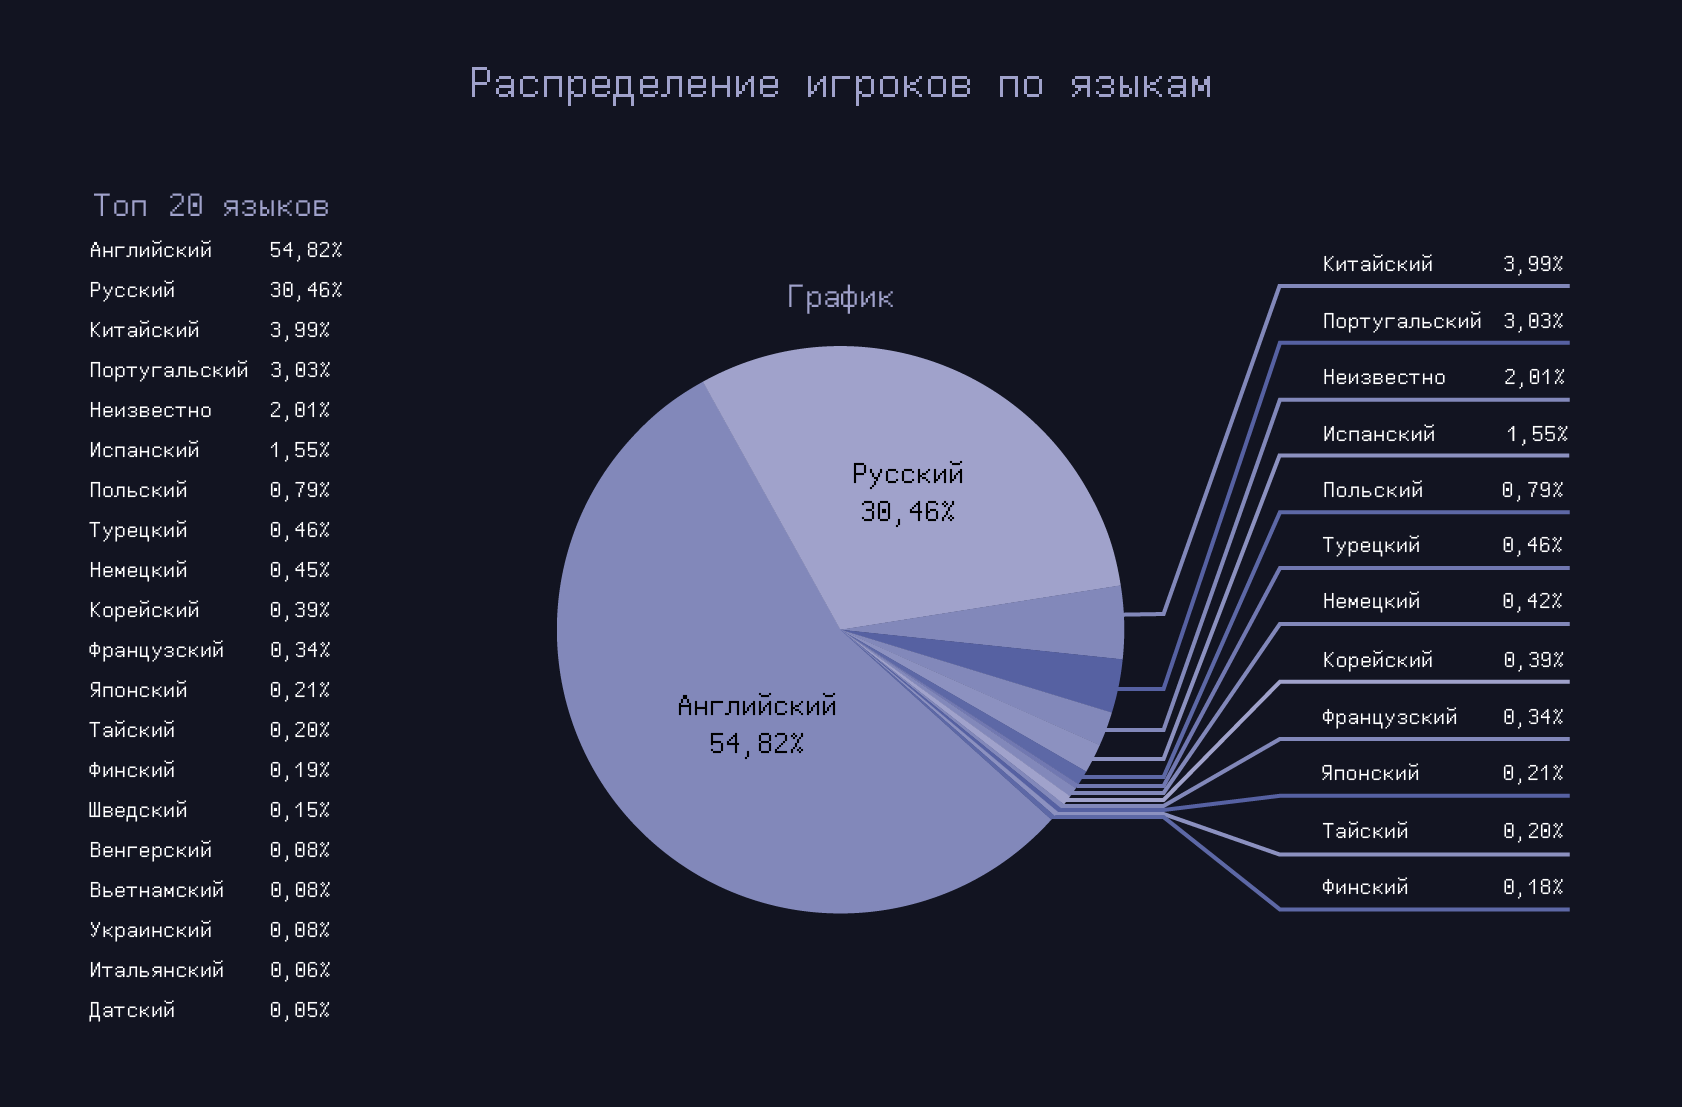
Английский преобладает, на втором месте русскоязычные игроки. Вместе эти языки составляют >90%.
Как именно происходило совмещение игрока с языковой принадлежностью будет позже.
Наконец у меня дошли руки до написания статьи об этом исследовании. В отличии от прошлой истории с Dota 2, я решил определять язык, а не страну.
В целом цель исследования — определить языки, которые чаще всего используют игроки Deadlock, и построить статистику их распределения. Для этого я использовал данные из реплеев, сообщений чата, а также дополнительные данные из HLStats и SourceBans. Всего было проанализировано 1,871,556 игроков - это то количество, которое я собрал за 4 месяца активного сбора данных.
Результаты
Английский язык оказался доминирующим среди игроков. В целом это и неудивительно.
Английский - 54.82%
Русский - 30.46%
Китайский - 3.99%
Португальский - 3.03%
Неизвестно - 2.01%
Испанский - 1.55%
Источники данных
Реплеи Deadlock:
- Основным источником данных стали игровые реплеи. Из-за отсутствия официального API был разработан собственный парсер мета из GC, позволивший извлечь данные из тысячи матчей.
- Я собрал 2,748,523 матчей собрал и проанализировал 1,710,462 (62%).
- С реплеев извлекались сообщения чата, которые использовались для определения языка.
Сообщения из Dota 2:
- Сообщения из матчей Dota 2 использовались как дополнительный источник текстовых данных.
- Зная как можно собирать сообщения из реплеев по прошлому опыту, я решил использовать этот метод и для Deadlock.
- К сожалению (или к счастью), покрывающей процент сообщений из Доты составил 12,74%, что неплохо на самом деле. Но я ожидал, что будет больше.
Данные HLStats и SourceBans:
- HLStats очень древняя платформа, которая собирает статистику по игрокам в различных онлайн-играх.
- SourceBans - на текущий момент самая популярная платформа для банов в играх на движке Source.
- Данные с этих платформ также использовались для анализа, так как многие проекты CS:GO, CS:S, Garry's Mod, TF2 и другие используют их для сбора статистики.
- Всего я спарсил порядка 100 проектов.
- ~9,000,000 записей из HLStats (покрытие 7.69% → 144,010 перекрестных записей)
- 550,000 записей из SourceBans (покрытие 0.34% → 6,423 перекрестных записей)
Информация с FACEIT:
- Данные с FACEIT оказались очень полезными, так как эта платформа предоставляет и регион и язык игрока.
- Покрытие составило 27,93% (522,677) записей.
Профили и комментарии Steam:
- Это довольно простой способ, на самом деле. Как и в прошлый раз я собирал профили и комментарии игроков, друзей и их профили, комментарии в Steam, что стало самым простым этапом сбора.
- Я также использовал данные с платформ, которые хранят историю о профилях Steam, такие как SteamDB, SteamRep и другие.
- Покрытие 100% записей.
Данный список составлен из открытых профилей, где есть доступ к играм. Результаты показывают количество копий игры, а не сами игры, откуда пришли игроки.
- Counter-Strike 2 - 488,502
- Deadlock - 429,828
- PUBG: BATTLEGROUNDS - 299,479
- Dota 2 - 292,088
- Apex Legends - 271,514
- Terraria - 231,634
- Tom Clancy's Rainbow Six Siege - 221,669
- Grand Theft Auto V - 208,577
- Team Fortress 2 - 208,222
- Garry's Mod - 205,086
- Wallpaper Engine - 201,039
- Left 4 Dead 2 - 192,809
1. Очистка данных: - Сначала данные очищались от лишних символов, ссылок и нормализовались для удобства анализа.
2. Вес источников: - по каждому типу данных был присвоен вес, который влиял на общий результат. Например, реплеи и сообщения чата имели больший вес, чем данные из HLStats или SourceBans. Также вес зависел от качества и количества данных.
3. Обработка: - Для самого анализа использовалась кастомная модель FastText, которая определяла языки с учётом веса каждого источника. Она была не единственная, но основная. Если язык не определялся или уверенность ответа была ниже 80%, я подключал другую модель lingua. Если и она не определяла язык, запись помечалась как ненадёжная и отправлялась на дополнительный анализ через Google Translate API и GPT. Некоторые записи так и остались неопределёнными, так как не удалось найти достаточно информации для точного определения, либо их общий вес оказался очень мал.
4. Подсчет: - После определения языка для каждого поля составлялся массив по игроку с количеством сообщений на каждом языке. Здесь я уже мог сделать выводы о языке игрока. Для каждого игрока я считал среднее значение по всем языкам и выбирал наиболее вероятный язык. Если уверенность была ниже 90% или источников оказалось очень мало - я финально отмечал запись как ненадёжную, а игроку присваивался статус "неизвестный".
Английский преобладает, на втором месте русскоязычные игроки. Вместе эти языки составляют >90%.
Как именно происходило совмещение игрока с языковой принадлежностью будет позже.
Анализ языкового распределения игроков в Deadlock
Наконец у меня дошли руки до написания статьи об этом исследовании. В отличии от прошлой истории с Dota 2, я решил определять язык, а не страну.
В целом цель исследования — определить языки, которые чаще всего используют игроки Deadlock, и построить статистику их распределения. Для этого я использовал данные из реплеев, сообщений чата, а также дополнительные данные из HLStats и SourceBans. Всего было проанализировано 1,871,556 игроков - это то количество, которое я собрал за 4 месяца активного сбора данных.
Результаты
Английский язык оказался доминирующим среди игроков. В целом это и неудивительно.
Английский - 54.82%
Русский - 30.46%
Китайский - 3.99%
Португальский - 3.03%
Неизвестно - 2.01%
Испанский - 1.55%
Источники данных
Реплеи Deadlock:
- Основным источником данных стали игровые реплеи. Из-за отсутствия официального API был разработан собственный парсер мета из GC, позволивший извлечь данные из тысячи матчей.
- Я собрал 2,748,523 матчей собрал и проанализировал 1,710,462 (62%).
- С реплеев извлекались сообщения чата, которые использовались для определения языка.
Сообщения из Dota 2:
- Сообщения из матчей Dota 2 использовались как дополнительный источник текстовых данных.
- Зная как можно собирать сообщения из реплеев по прошлому опыту, я решил использовать этот метод и для Deadlock.
- К сожалению (или к счастью), покрывающей процент сообщений из Доты составил 12,74%, что неплохо на самом деле. Но я ожидал, что будет больше.
Данные HLStats и SourceBans:
- HLStats очень древняя платформа, которая собирает статистику по игрокам в различных онлайн-играх.
- SourceBans - на текущий момент самая популярная платформа для банов в играх на движке Source.
- Данные с этих платформ также использовались для анализа, так как многие проекты CS:GO, CS:S, Garry's Mod, TF2 и другие используют их для сбора статистики.
- Всего я спарсил порядка 100 проектов.
- ~9,000,000 записей из HLStats (покрытие 7.69% → 144,010 перекрестных записей)
- 550,000 записей из SourceBans (покрытие 0.34% → 6,423 перекрестных записей)
Информация с FACEIT:
- Данные с FACEIT оказались очень полезными, так как эта платформа предоставляет и регион и язык игрока.
- Покрытие составило 27,93% (522,677) записей.
Профили и комментарии Steam:
- Это довольно простой способ, на самом деле. Как и в прошлый раз я собирал профили и комментарии игроков, друзей и их профили, комментарии в Steam, что стало самым простым этапом сбора.
- Я также использовал данные с платформ, которые хранят историю о профилях Steam, такие как SteamDB, SteamRep и другие.
- Покрытие 100% записей.
Результаты по играм
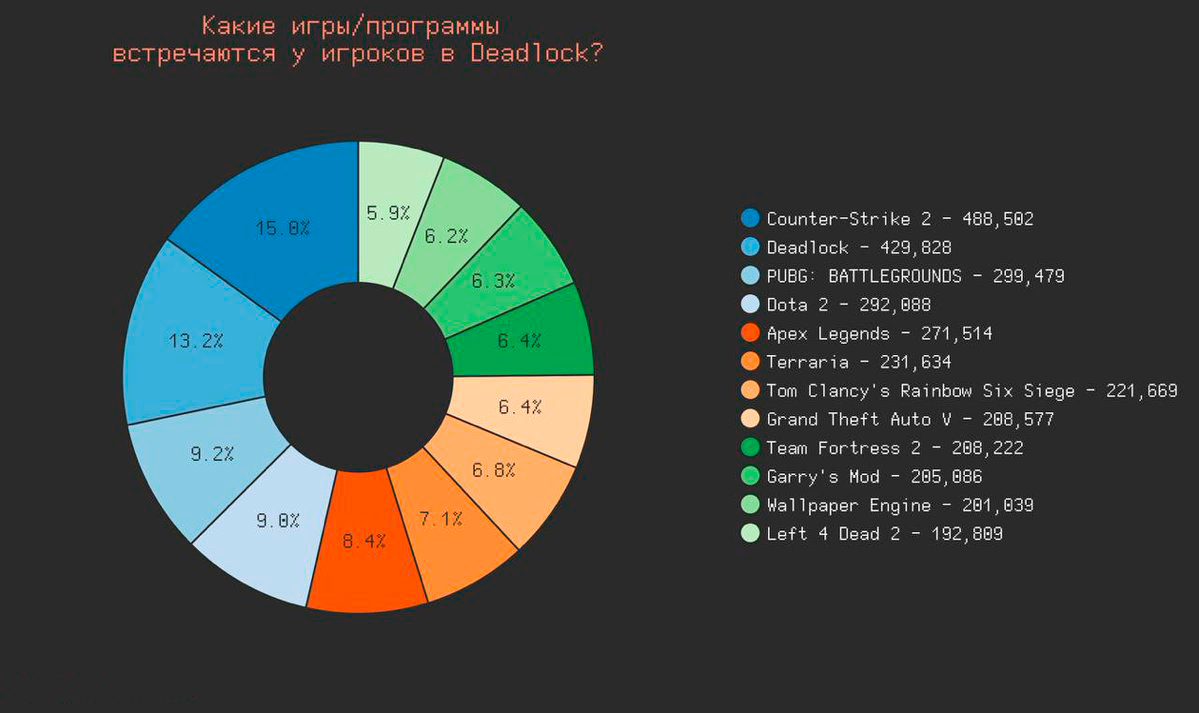
Данный список составлен из открытых профилей, где есть доступ к играм. Результаты показывают количество копий игры, а не сами игры, откуда пришли игроки.
- Counter-Strike 2 - 488,502
- Deadlock - 429,828
- PUBG: BATTLEGROUNDS - 299,479
- Dota 2 - 292,088
- Apex Legends - 271,514
- Terraria - 231,634
- Tom Clancy's Rainbow Six Siege - 221,669
- Grand Theft Auto V - 208,577
- Team Fortress 2 - 208,222
- Garry's Mod - 205,086
- Wallpaper Engine - 201,039
- Left 4 Dead 2 - 192,809
Подробнее об обработке данных
1. Очистка данных: - Сначала данные очищались от лишних символов, ссылок и нормализовались для удобства анализа.
2. Вес источников: - по каждому типу данных был присвоен вес, который влиял на общий результат. Например, реплеи и сообщения чата имели больший вес, чем данные из HLStats или SourceBans. Также вес зависел от качества и количества данных.
3. Обработка: - Для самого анализа использовалась кастомная модель FastText, которая определяла языки с учётом веса каждого источника. Она была не единственная, но основная. Если язык не определялся или уверенность ответа была ниже 80%, я подключал другую модель lingua. Если и она не определяла язык, запись помечалась как ненадёжная и отправлялась на дополнительный анализ через Google Translate API и GPT. Некоторые записи так и остались неопределёнными, так как не удалось найти достаточно информации для точного определения, либо их общий вес оказался очень мал.
4. Подсчет: - После определения языка для каждого поля составлялся массив по игроку с количеством сообщений на каждом языке. Здесь я уже мог сделать выводы о языке игрока. Для каждого игрока я считал среднее значение по всем языкам и выбирал наиболее вероятный язык. Если уверенность была ниже 90% или источников оказалось очень мало - я финально отмечал запись как ненадёжную, а игроку присваивался статус "неизвестный".


